
Pair Distribution Functions (PDF) pipeline#
简介#
此项目是面向先进光源 HEPS 的数据处理软件框架 Daisy 的学科应用示范之一,主要服务于B1、B3、B6、B9等线站,项目主页位于 Daisy-PDF。
版本#
v1.0,目前仅具备用于测试的基本功能,很可能有 bug 存在,欢迎各位提出意见、建议和批评指正。
技术路线#
Docker+JupyterLab,Client-Server mode。
数据处理流程#
主要为原数据积分和获取 PDF 函数两大步骤。具体如下图所示,

界面入口#
网站页面#
目前开放了 hepscs 平台,仅用于 HEPS 前期开发、测试,用户需要:
申请注册高能所 SSO (单点登录)账号
申请集群账号并加入 HEPSBL 用户组
使用所外网络访问时,可能 还需要高能所提供的 VPN
以下均以 Firefox 浏览器上的 hepcs 为例,不同浏览器可能字体、布局略有区别;登录后的界面如下:

按上图中的顺序提示,先选择 PDF 应用所属镜像 daisydev,然后点击下方的长按钮,约几秒后便可进入计算环境。
Jupyterlab Launcher页面#
进入计算环境后,整体的界面如下所示,

其中,标记为1的红色虚线框内,是文件浏览器部分,默认展示的是用户目录下的文件内容,因此不同用户,此处的内容也是不同的;标记为2的红色虚线框内,是主界面 Launcher 中需要我们关注的部分,后续随着应用、软件等的开发,此处会不断调整和丰富。
主界面基本布局#
点击 PDF 图标进入到 Daisy-PDF 的主界面(根据网络情况,大约等待几秒钟)后,主界面如图,

从上到下共三部分:
子项目图标和标题
含有三个 tab 页的主体
版权信息
分界面功能介绍#
pipeline(进入后的默认tab)#
本分页面是 Daisy-PDF 的主体,如名所示,是配置和运行整个数据处理流程的流水线。
界面中最上方的部分,是选择衍射数据所在路径/位置和数据处理结果输出路径/位置的地方,如下图所示;并且,为了方便用户的选择,下方提供了用于数据图像 预览 和 过滤 的功能,经过过滤后的文件将被用于后续的处理。
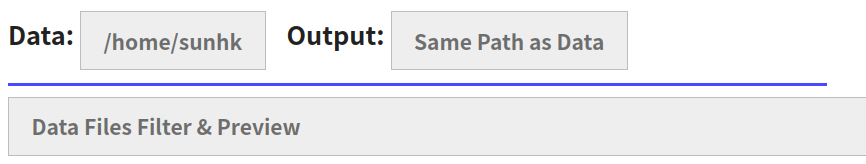
本项目所有的 文件(夹) 选择界面遵循同样的使用逻辑,单击后如下图所示,文件夹单击进入,点击上方第二项**<Parent Folder>**则是退回到上级文件夹;

如果想选择当前的目录,点击第一项**<Choose Folder>**,展开的下拉框会自动收回,并且页面上会出现一个绿色的原点表示已选择,如下图。
PS: BSRF上3W1线站的PDF数据位于
/hepsfs/public_database/3w1pdf/路径下。
结果输出位置默认是和数据文件相同,但强烈建议选择更合适的文件夹。
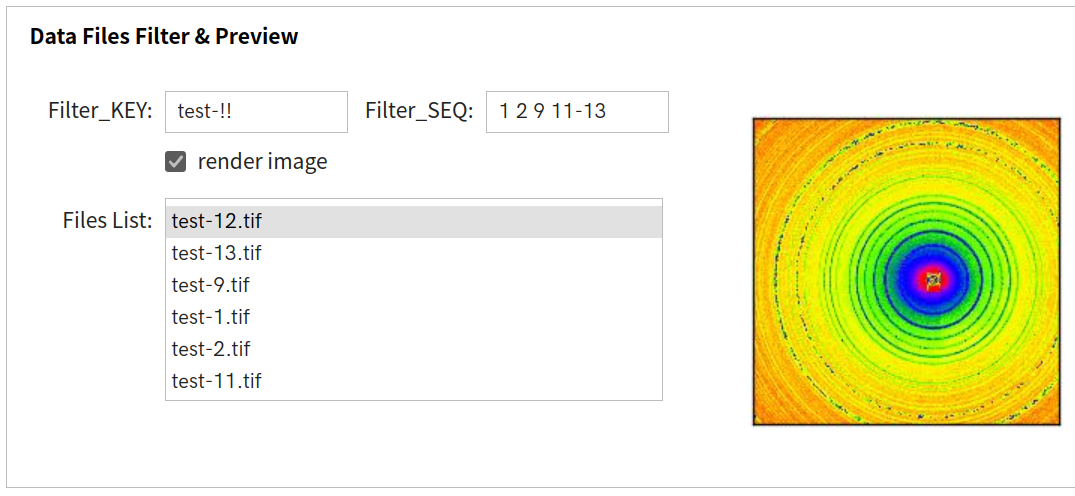
数据文件的预览和过滤/筛选如下图所示,过滤的功能分为两部分,左侧是最常见的关键词过滤;
右侧的功能则是:考虑到线站上往往同一样品会测量非常多组,然后命名常以数字顺序结尾。假设用户只想处理其中部分的文件,则可在这里填上相应的序列数字或者连续区间。比如第3号到第11号,只需输入
3-11;需要注意的是:使用这一功能,需要在左侧填入
!!作为序列数字的占位符,用以表示序列和关键词的位置关系。当用户使用过滤功能后,仅过滤后的文件会被用于后续处理,这一点请特别注意!
选择下方相应的文件,即可预览,由于有些数据文件在纯的灰度展示下难以分辨,所以默认开启了渲染。
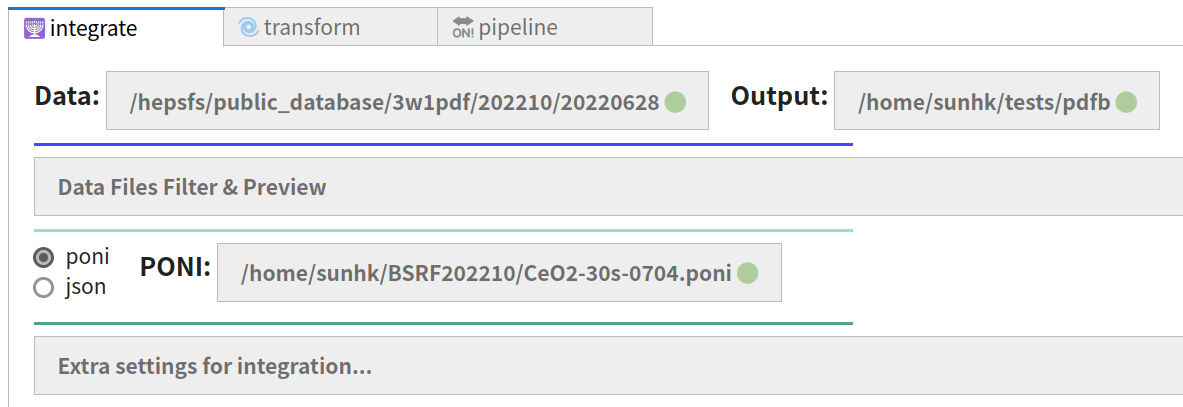
界面的中间部分,如下图所示,是 配置文件 选择的地方,包括用于积分的
poni或json文件和用于获取 PDF 函数的cfg文件。这里的文件选择器没有了**<Choose Folder>**选项,文件选好后,点击即可选定。
对于不同的选择器,我们也提供了按文件的后缀名自动过滤的功能,方便用户选取相应的配置文件。例如选
cfg文件时,选择器只会展示当前文件夹下的以cfg为文件扩展名的文件供用户选择。
下方的第三部分则面向高级用户,允许其对积分或者获取 PDF 的配置参数进行额外的设置,优先级高于配置文件。


最下方的部分是 运行/停止 按钮和结果展示。
点击
Run按钮即可以CPU多核的形式并行进行加速计算,这对于多数据文件的处理是很高效的。
integarte 积分#
积分部分,仅包括衍射数据文件的批量积分功能,详细的使用说明已经包含在 pipeline 一节中。
transform 获取PDF#
获取 PDF 部分,仅包括将积分后的文件(.chi)计算得到相应的 PDF 文件,目前支持4种输出类型 [gr, iq, fq, sq],详细的使用说明已经包含在 pipeline 一节中。

后续开发计划#
界面层面#
衍射数据预览功能加强,包括局部放大、多种渲染器支持等
参数设置更全面且支持生成配置文件
(待补充 –>)
功能层面#
masking功能实现
mapping plot
PDF寻峰
(待补充 –>)